

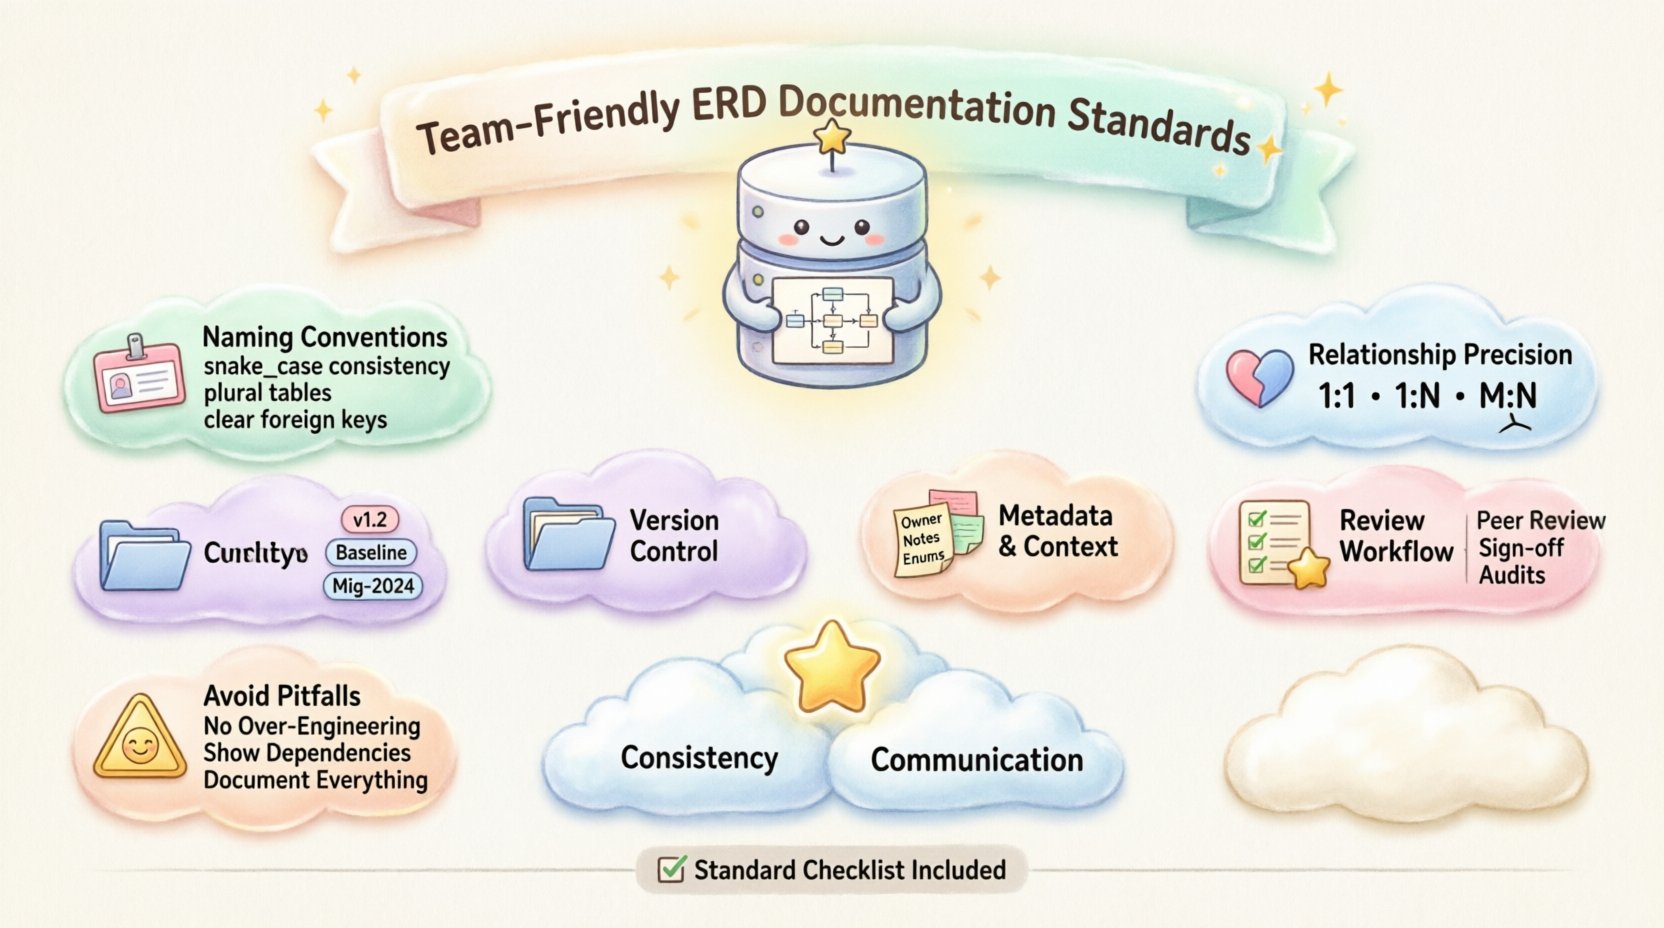
प्रभावी डेटा मॉडलिंग किसी भी मजबूत अनुप्रयोग वास्तुकला की रीढ़ है। जब टीमें डेटाबेस स्कीमा पर सहयोग करती हैं, तो एंटिटी रिलेशनशिप डायग्राम (ERD) एकमात्र सत्य स्रोत के रूप में कार्य करता है। हालाँकि, मानकीकृत दस्तावेज़ीकरण प्रथाओं के बिना, ये डायग्राम अक्सर स्पष्टता के बजाय भ्रम के स्रोत बन जाते हैं। संरचना में अस्पष्टता असंगत विकास, बढ़े हुए बग्स और धीमी डिप्लॉयमेंट चक्रों का कारण बनती है। यह गाइड ऐसे ERD दस्तावेज़ीकरण बनाने के लिए आवश्यक मानकों को रेखांकित करती है जो निरंतर टीम सहयोग का समर्थन करता है।
डेटा मॉडलिंग केवल बॉक्स और लाइनें खींचने के बारे में नहीं है। यह डेटाबेस प्रशासकों, बैकएंड इंजीनियरों और उत्पाद प्रबंधकों के बीच एक संचार प्रोटोकॉल है। जब सभी एक ही दृश्य भाषा बोलते हैं, तो गलत व्याख्या का जोखिम काफी कम हो जाता है। निम्नलिखित अनुभाग उच्च-गुणवत्ता वाले दस्तावेज़ीकरण को बनाए रखने के लिए आवश्यक संरचनात्मक, व्याकरणिक और प्रक्रियात्मक मानकों का विस्तार से वर्णन करते हैं।
📝 मौलिक नामकरण परंपराएँ
नामकरण परंपराएँ किसी भी दस्तावेज़ीकरण सेट में स्पष्टता की पहली परत का निर्माण करती हैं। असंगत नामकरण संज्ञानात्मक घर्षण पैदा करता है। एक डेवलपर जो स्कीमा पढ़ रहा हो, उसे यह अनुमान लगाने की आवश्यकता नहीं होनी चाहिए कि एक कॉलम नाम क्या दर्शाता है। मानकीकरण सुनिश्चित करता है कि नाम पूरे परियोजना में भविष्यवाणी योग्य हों।
- संगति प्रमुख है: पूरे संगठन के लिए एकल शैली गाइड अपनाएं। चाहे आप snake_case, camelCase, या PascalCase चुन रहे हों, निर्णय एक बार लिया जाना चाहिए और सार्वभौमिक रूप से लागू किया जाना चाहिए।
- बहुवचन बनाम एकवचन: तालिकाएँ आमतौर पर इकाइयों के संग्रह को दर्शाती हैं, इसलिए बहुवचन नामकरण (उदाहरण के लिए, “
उपयोगकर्ताओं,आदेशों) को अक्सर प्राथमिकता दी जाती है। उन तालिकाओं के भीतर कॉलम एकवचन होने चाहिए (उदाहरण के लिए, “user_id,order_date). - विदेशी कुंजी स्पष्टता: संबंधों को स्पष्ट रूप से नाम देना समझने में सहायता करता है। एक कॉलम जो “
उपयोगकर्ताओंतालिका का संदर्भ देता है, आदर्श रूप से “user_idके रूप में नामित होना चाहिए, न कि केवल “id“। इससे यह स्पष्ट हो जाता है कि संबंध किस तालिका से संबंधित है। - विशेष वर्ण:तालिका या कॉलम नामों में खाली स्थान और विशेष वर्णों से बचें। इनकी आवश्यकता SQL क्वेरी में उद्धरण के लिए होती है और स्वचालित उपकरणों में त्रुटियाँ पैदा कर सकती है। इसके बजाय अंडरस्कोर या camelCase का उपयोग करें।
- क्षर संवेदनशीलता:अंतर्निहित डेटाबेस इंजन के प्रति सचेत रहें। कुछ प्रणालियाँ क्षर-संवेदनशील होती हैं, जबकि अन्य नहीं। मानक क्षर शैली का दस्तावेज़ीकरण विभिन्न वातावरणों में डिप्लॉयमेंट समस्याओं को रोकता है।
दीर्घकालिक रखरखाव पर नामकरण के प्रभाव पर विचार करें। जैसे-जैसे प्रणाली बढ़ती है, नए डेवलपर टीम में शामिल होंगे। स्पष्ट नामों से डेटा संरचना को समझने के लिए आवश्यक ऑनबोर्डिंग समय कम हो जाता है। गुमनाम होने के बजाय विस्तृत होना बेहतर है। एक नाम जैसे “ग्राहक_प्रमुख_ईमेल_पता अधिक स्पष्ट है cp_email, भले ही दूसरा छोटा हो।
🔗 सटीकता के साथ संबंधों को परिभाषित करना
एंटिटी के बीच के संबंध डेटा मॉडल की अखंडता को परिभाषित करते हैं। एक ERD को स्पष्ट रूप से यह संचारित करना चाहिए कि डेटा बिंदु कैसे जुड़ते हैं। धुंधली रेखाएं और अनुपलब्ध लेबल ऐसे अनुमानों की ओर ले जाते हैं जो अक्सर कार्यान्वयन के दौरान गलत साबित होते हैं।
कार्डिनैलिटी नोटेशन
कार्डिनैलिटी एंटिटी के बीच की संख्यात्मक संबंध को वर्णित करती है। आरेख में उपयोग की जाने वाली नोटेशन को मानकीकृत करने से गलत व्याख्या को रोका जा सकता है।
- एक-से-एक (1:1):संकेत करता है कि एक तालिका में एक रिकॉर्ड दूसरी तालिका में ठीक एक रिकॉर्ड के अनुरूप होता है। यह संवेदनशील डेटा अलगाव या विशिष्ट प्रोफ़ाइल विस्तारों के लिए सामान्य है।
- एक-से-अनेक (1:N): सबसे सामान्य संबंध। पैरेंट तालिका में एक रिकॉर्ड चिल्ड तालिका में कई रिकॉर्डों से संबंधित होता है। उदाहरण के लिए, एक
ग्राहककईऑर्डर. - अनेक-से-अनेक (M:N): एक मध्यवर्ती जंक्शन तालिका की आवश्यकता है। इसे लॉजिकल मॉडल में बिना ब्रिज एंटिटी के कभी भी सीधी रेखा के रूप में नहीं दर्शाया जाना चाहिए। संरचना को स्पष्ट करने के लिए जंक्शन तालिका को स्पष्ट रूप से दिखाएं।
वैकल्पिकता और प्रतिबंध
सभी संबंध अनिवार्य नहीं होते हैं। आरेख को यह संकेत देना चाहिए कि क्या संबंध वैकल्पिक है या आवश्यक है।
- अनिवार्य भागीदारी: चिल्ड तालिका में हर रिकॉर्ड का एक पैरेंट होना चाहिए। उदाहरण के लिए, हर
लाइन_आइटमको एकऑर्डर. - वैकल्पिक भागीदारी: एक रिकॉर्ड पैरेंट के बिना भी अस्तित्व में हो सकता है। उदाहरण के लिए, एक
उपयोगकर्ताप्रोफ़ाइल में लिंक किया हुआभुगतान विधिपंजीकरण के तुरंत बाद।
यहाँ दृश्य संकेतन महत्वपूर्ण है। इन बाधाओं को दर्शाने के लिए विशिष्ट प्रतीकों (जैसे कौए के पैर या विशिष्ट रेखा समापक) का उपयोग करें। नियमों को समझाने के लिए केवल पाठ पर निर्भर न रहें। दृश्य प्रतिनिधित्व तकनीकी दर्शकों के लिए स्व-स्पष्ट होना चाहिए।
📂 डेटाबेस स्कीमा के लिए संस्करण नियंत्रण
बिल्कुल उसी तरह जैसे एप्लिकेशन कोड को संस्करण नियंत्रण की आवश्यकता होती है, वैसे ही डेटाबेस स्कीमा को भी। दस्तावेज़ीकरण एक स्थिर कलाकृति नहीं है; यह सिस्टम के साथ विकसित होता है। परिवर्तनों को ट्रैक करने की प्रक्रिया के बिना, आरेख अनिवार्य रूप से वास्तविक डेटाबेस स्थिति से दूर चला जाएगा।
- परिवर्तन लॉग: ERD में प्रत्येक संशोधन को रिकॉर्ड किया जाना चाहिए। इसमें तारीख, लेखक, परिवर्तन की प्रकृति और परिवर्तन का कारण शामिल है।
- बेसलाइन संस्करण: विशिष्ट रिलीज़ के लिए एक बेसलाइन स्थापित करें। यदि कोई विशेषता निर्मित की जा रही है, तो दस्तावेज़ीकरण को उस विशेषता के लिए आवश्यक स्कीमा की स्थिति को दर्शाना चाहिए।
- स्थानांतरण ट्रैकिंग: दस्तावेज़ीकरण को स्थानांतरण स्क्रिप्ट से लिंक करें। यदि कोई कॉलम जोड़ा जाता है, तो दस्तावेज़ीकरण को उस स्थानांतरण स्क्रिप्ट का संदर्भ देना चाहिए जो इस परिवर्तन को लागू करती है।
- विवाद निपटान: जब कई टीमें स्कीमा को संशोधित करती हैं, तो संस्करणनीति ओवरराइट को रोकती है। अनजाने में विवादों से बचने के लिए प्रत्येक स्कीमा खंड के मालिक की पहचान करें।
समय के साथ आरेख की अखंडता बनाए रखना अत्यंत आवश्यक है। एक पुराना आरेख बिना आरेख के भी बुरा है, क्योंकि यह एक झूठी सुरक्षा की भावना पैदा करता है। टीमें ऐसी जानकारी के आधार पर विशेषताएं बना सकती हैं जो अब मौजूद नहीं है।
📄 मेटाडेटा और संदर्भित जानकारी
तकनीकी विवरण पर्याप्त नहीं हैं। दस्तावेज़ीकरण में निर्णय लेने के लिए संदर्भ प्रदान करने वाले मेटाडेटा को शामिल करना चाहिए। एक विशिष्ट डिज़ाइन चयन क्यों किया गया? इस डेटा का मालिक कौन है?
मालिकाना हक और देखभाल
विशिष्ट तालिकाओं या स्कीमा के लिए मालिकाना हक सौंपें। इससे यह स्पष्ट होता है कि प्रश्नों या परिवर्तनों के लिए किससे संपर्क किया जाए।
- डेटा स्टीवर्ड: उस व्यक्ति की पहचान करें जिसे तालिका के भीतर डेटा की सटीकता के लिए जिम्मेदार माना जाता है।
- तकनीकी मालिक: उस प्रमुख इंजीनियर की पहचान करें जिसे स्कीमा संरचना के रखरखाव के लिए जिम्मेदार माना जाता है।
- व्यापार मालिक: उस उत्पाद या व्यापार हितधारक की पहचान करें जो डेटा के लिए आवश्यकताओं को परिभाषित करता है।
वर्णनात्मक नोट्स
जटिल व्यापार तर्क अक्सर केवल रेखाओं द्वारा दर्शाया नहीं जा सकता। विशिष्ट नियमों को समझाने के लिए नोट्स जोड़ें।
- गणना तर्क: यदि कोई कॉलम एक गणना किया गया मान है, तो उपयोग की गई सूत्र को दस्तावेज़ करें।
- एन्यूम मान: उन कॉलमों के लिए जिनके पास मानों का सीमित सेट होता है (जैसे,
स्थिति), अनुमत मानों और उनके अर्थों की सूची दें। - प्राचीनित क्षेत्र:स्पष्ट रूप से उन क्षेत्रों को चिह्नित करें जो अब उपयोग में नहीं हैं। संकेत दें कि उन्हें कब प्राचीनित किया गया था और उन्हें हटाने की कब योजना बनाई गई है।
यह संदर्भ एक तकनीकी आरेख को एक व्यावसायिक संपत्ति में बदल देता है। यह नए टीम सदस्यों को *क्या* के पीछे के *क्यों* को समझने में मदद करता है।
🔄 समीक्षा और अनुमोदन के लिए कार्यप्रवाह
प्रक्रिया के बिना मानक बेकार हैं। एक समीक्षा कार्यप्रवाह स्थापित करना सुनिश्चित करता है कि दस्तावेज़ सटीक बने रहें और परियोजना के लक्ष्यों के साथ समन्वित हों।
- सहकर्मी समीक्षा:स्कीमा परिवर्तनों को विलय करने से पहले कम से कम एक सहकर्मी समीक्षा आवश्यक है। यह नामकरण असंगतियों और तर्क त्रुटियों को पकड़ता है।
- हितधारकों की स्वीकृति:महत्वपूर्ण संरचनात्मक परिवर्तनों के लिए, व्यावसायिक हितधारकों को डेटा रिपोर्टिंग और उपयोगकर्ता अनुभव पर प्रभाव की समीक्षा करनी चाहिए।
- स्वचालित जाँच:जहाँ संभव हो, उपकरणों का उपयोग करें ताकि सुनिश्चित किया जा सके कि वास्तविक डेटाबेस दस्तावेज़ से मेल खाता है। इससे मान्यीकरण की मानव श्रम में कमी आती है।
- नियमित ऑडिट:नियमित ऑडिट निर्धारित करें ताकि सुनिश्चित किया जा सके कि दस्तावेज़ उत्पादन वातावरण से विचलित नहीं हुए हैं।
सहयोग एक निरंतर लूप है। यह परियोजना की शुरुआत में एक बार की गतिविधि नहीं है। जैसे-जैसे आवश्यकताएँ बदलती हैं, दस्तावेज़ भी उनके साथ बदलने चाहिए।
⚠️ ERD डिज़ाइन में सामान्य गलतियाँ
मानकों के होने के बावजूद, टीमें अक्सर सामान्य फँदों में फंस जाती हैं। इन गलतियों को शीघ्र पहचानने से महत्वपूर्ण समय और प्रयास बच सकता है।
- अति-इंजीनियरिंग:हर संभावित भविष्य के परिदृश्य के लिए डिज़ाइन करने से अनावश्यक जटिलता होती है। वर्तमान आवश्यकताओं पर ध्यान दें और संरचना को अत्यधिक जटिल किए बिना विकास के लिए स्थान छोड़ें।
- प्रदर्शन को नजरअंदाज करना:कागज़ पर एक आदर्श स्कीमा उत्पादन में खराब प्रदर्शन कर सकता है। डिज़ाइन चरण में इंडेक्सिंग रणनीतियों और क्वेरी पैटर्न पर विचार करें।
- छिपे हुए निर्भरताएँ:सुनिश्चित करें कि सभी विदेशी कुंजी संबंध स्पष्ट हैं। छिपा हुआ तर्क नाजुक प्रणालियाँ बनाता है जो आसानी से टूट जाती हैं।
- दस्तावेज़ीकरण की कमी:सहायक पाठ के बिना केवल आरेख पर निर्भर रहना जोखिम भरा है। जटिल तर्क के लिए संदर्भिक नोट्स आवश्यक हैं।
📋 एक व्यापक मानक जाँच सूची
प्रकाशन से पहले अपनी दस्तावेज़ीकरण की जाँच स्थापित मानकों के खिलाफ करने के लिए इस तालिका का उपयोग करें।
| श्रेणी | आवश्यकता | प्राथमिकता |
|---|---|---|
| नामकरण | सभी तालिकाओं के नाम बहुवचन और snake_case में हैं | उच्च |
| नामकरण | विदेशी कुंजियाँ पैटर्न का पालन करती हैं _id |
उच्च |
| संबंध | कार्डिनैलिटी स्पष्ट रूप से चिह्नित की गई है | उच्च |
| संबंध | बहु-से-बहु संबंध जंक्शन तालिकाओं का उपयोग करते हैं | उच्च |
| मेटाडेटा | स्तंभ डेटा प्रकार निर्दिष्ट किए गए हैं | मध्यम |
| मेटाडेटा | डिफ़ॉल्ट मान दस्तावेज़ीकृत हैं | मध्यम |
| संस्करण | परिवर्तन लॉग अप-टू-डेट है | मध्यम |
| संस्करण | डायग्राम पर संस्करण संख्या दिखाई देती है | उच्च |
| पहुँच योग्यता | डायग्राम सभी टीम सदस्यों के लिए उपलब्ध है | उच्च |
| पहुँच योग्यता | प्रतीकों के लिए प्रतीक सूची शामिल है | मध्यम |
कार्यान्वयन दिशानिर्देश
इन मानकों को अपनाने के लिए अनुशासन की आवश्यकता है। नियमों का होना पर्याप्त नहीं है; उन्हें दैनिक कार्यप्रवाह में एकीकृत किया जाना चाहिए।
- नियुक्ति प्रक्रिया:नए कर्मचारियों के अभिमुखीकरण में दस्तावेज़ीकरण मानकों को शामिल करें। प्रत्येक नियम के पीछे के तर्क को समझाएं।
- नमूने:ERD के लिए ऐसे नमूने बनाएं जिनमें आवश्यक शीर्षक, प्रतीक सूची और मेटाडेटा अनुभाग शामिल हों।
- कोड समीक्षा:स्कीमा दस्तावेज़ीकरण को कोड समीक्षा प्रक्रिया का हिस्सा मानें। अपडेटेड दस्तावेज़ीकरण के बिना स्कीमा में परिवर्तन विलय न करें।
- प्रतिक्रिया लूप:टीम सदस्यों को मानकों में सुधार सुझाने के लिए प्रोत्साहित करें। प्रक्रिया को विकसित होना चाहिए।
🚀 समय के साथ गुणवत्ता बनाए रखना
उच्च-गुणवत्ता वाले ERD दस्तावेज़ीकरण को बनाए रखना एक निरंतर प्रयास है। इसमें स्पष्टता के प्रति प्रतिबद्धता और आवश्यक होने पर डेटा और दस्तावेज़ीकरण दोनों को पुनर्गठित करने की इच्छा की आवश्यकता होती है।
जब टीमें इन मानकों में निवेश करती हैं, तो लाभ स्पष्ट होता है। विकास तेज हो जाता है क्योंकि आवश्यकताओं को स्पष्ट करने में कम समय लगता है। त्रुटियां कम होती हैं क्योंकि प्रतिबंध स्पष्ट होते हैं। संचार सुधरता है क्योंकि दृश्य भाषा साझा की जाती है।
वर्तमान दस्तावेज़ीकरण की जांच से शुरू करें। उन क्षेत्रों की पहचान करें जहाँ भ्रम सबसे अधिक होता है। इस गाइड में वर्णित मानकों को पहले उन विशिष्ट क्षेत्रों पर लागू करें। धीरे-धीरे कवरेज को बढ़ाएं जब तक कि पूरा सिस्टम नए मानकों का पालन न करे।
डेटा एक संपत्ति है। स्पष्ट दस्तावेज़ीकरण के माध्यम से इसकी अखंडता की रक्षा करना एक तकनीकी टीम द्वारा किया जा सकने वाले सबसे मूल्यवान योगदानों में से एक है। इन दिशानिर्देशों का पालन करके, आप सुनिश्चित करते हैं कि आपका डेटा मॉडल पूरे अनुप्रयोग पारिस्थितिकी तंत्र के लिए एक विश्वसनीय आधार बना रहे।
स्पष्टता, स्थिरता और संचार पर ध्यान दें। ये तीन स्तंभ एक दस्तावेज़ीकरण रणनीति का समर्थन करते हैं जो सॉफ़्टवेयर के जीवन चक्र भर टीम के लिए अच्छी तरह से काम करती है।