

堅牢なデータベースの構築は、最初のコード行を書くるるずっと前から始まります。その基盤は、ビジネス運営を駆動するロジックを理解することにあります。ビジネス要件が曖昧であったり誤解されたりすると、結果として生じるデータ構造は脆くなります。このガイドでは、ビジネスルールをエンティティリレーションシップ図(ERD)に変換するための構造化されたアプローチを提供します。このプロセスにより、特定のツールやプラットフォームに依存することなく、データベーススキーマが組織のニーズを正確に反映することが保証されます。
抽象的な概念を具体的なデータモデルに変換するには、正確さが求められます。ビジネスルールは以下のように述べるかもしれません。「顧客は複数の注文を提出できますが、各注文はちょうど1人の顧客に属します」適切な変換が行われない場合、このロジックは実装中に失われたり誤解されたりする可能性があります。体系的なフレームワークに従うことで、技術チームはスケーラブルで保守可能であり、運用上の現実と整合性のあるスキーマを作成できます。
ビジネスルールの核心コンポーネントの理解 🧩
図を描く前に、ステークホルダーから提供された情報を分解する必要があります。ビジネスルールは単なる好意ではなく、データがどのように使用され、処理されるかを支配する制約と定義です。これらはいくつかのカテゴリーに分類され、それぞれがデータベース設計に異なる影響を与えます。
- 構造的ルール:どのようなデータが存在するかを定義します。例えば、「すべての従業員は一意のID番号を持つ必要があります。」
- 手続的ルール:データがどのように処理されるかを定義します。例えば、「1000ドルを超える注文は、出荷前に管理者の承認が必要です。」
- 状態ルール:特定のアクションに対して真でなければならない条件を定義します。例えば、「残高がゼロでない場合、口座を閉鎖することはできません。」
- 変換ルール:データがどのように変化するかを定義します。例えば、「配送先住所が変更された場合、税率は再計算されなければなりません。」
これらの区別を認識することは、データモデル内でそれらがどこに属するかを決定するのに役立ちます。構造的ルールはしばしばエンティティと属性になります。手続的ルールはトリガーやストアドプロシージャになるかもしれませんが、テーブル間の関係を明確にします。状態ルールはしばしば制約と検証ロジックを規定します。
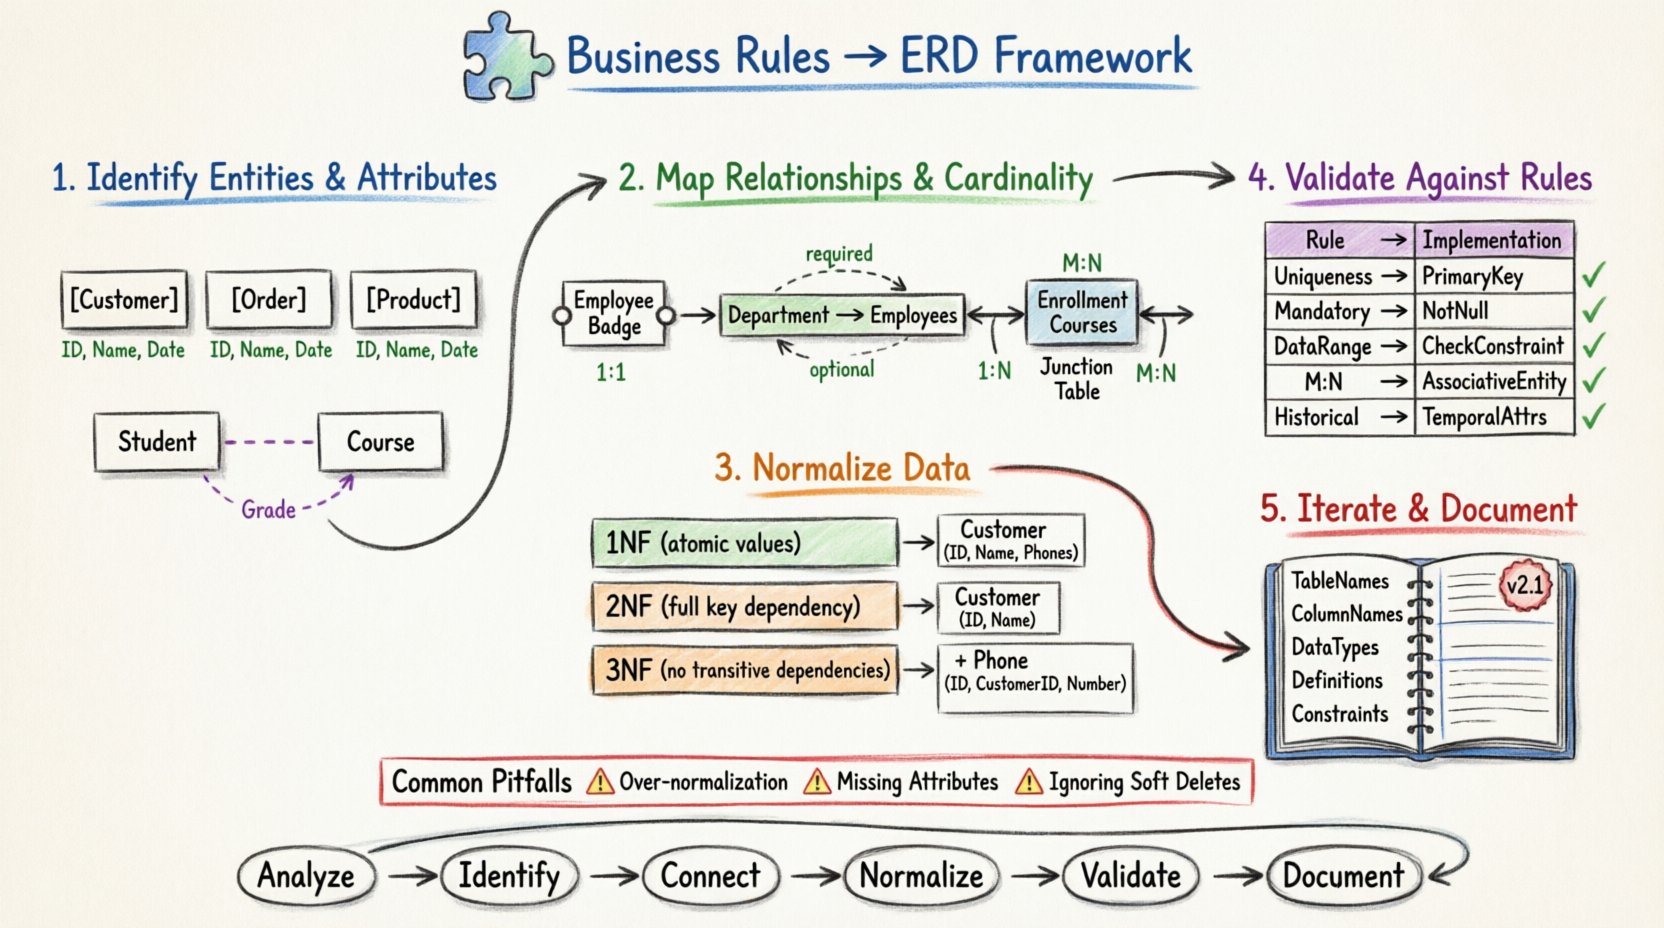
ステップ1:エンティティと属性の特定 🏢
データモデリングにおける最初の主要なステップは、ビジネスルール内の名詞を特定することです。これらの名詞は通常、エンティティを表します。エンティティは、データが格納される現実世界のオブジェクトまたは概念です。エンティティが特定されると、それに関連する形容詞や記述子が属性になります。
1.1 潜在的なエンティティの抽出
ドキュメントやインタビューの転記資料をキーワードで確認してください。頻繁に言及される名詞を探してください。例えば、小売の文脈では、「製品, 店舗, サプライヤー、および顧客」が強力な候補となります。
- テキストを確認する:一意のオブジェクトを表すすべての名詞にハイライトを付けてください。
- 重複をフィルタリング:“アイテム”と”製品”が同じ概念を指す場合、それらを別々のエンティティとして扱わないようにしてください。
- 関連関係を確認する:一部の名詞は他の名詞の属性である可能性があります。”住所”は通常、”顧客”の属性であり、システムが顧客ごとに複数の住所を追跡しない限り、別々のエンティティではありません。
1.2 属性の定義
エンティティが確立されたら、それらを記述するデータポイントを定義してください。属性は、エンティティを識別し記述するために必要な詳細情報を提供します。
- 主キー:各エンティティの一意の識別子を特定してください。これはデータ整合性にとって極めて重要です。
- 記述的属性:名前、日付、または説明などのプロパティをリストアップしてください。
- 計算属性:導出が必要な値をメモしてください。ただし、これらは通常、アプリケーション層で処理されます。
以下のルールを考慮してください:“学生はコースに登録し、成績を受け取る。”
- エンティティ:学生、コース、履修登録。
- 属性:学生ID、氏名、コースID、タイトル、成績、登録日。
次の点に注意してください:成績は学生またはコース単独では属性ではありません。それはそれらの間の関係に固有です。この認識は、しばしば関連エンティティの作成につながります。
ステップ2:関係とカーディナリティのマッピング 🔗
関係は、エンティティがどのように互いに相互作用するかを定義します。データモデリングにおける最も一般的なエラーの原因は、関係が明確に定義されていない場合や、カーディナリティが誤解されている場合です。カーディナリティは、あるエンティティのインスタンスが、別のエンティティのインスタンスと関連付けられる、または関連付けなければならないインスタンスの数を指定します。
2.1 関係の特定
ビジネスルール中の動詞を探してください。動詞はしばしばエンティティ間の関係を示します。一般的な動詞には割り当てる, 含む, 雇用する、または購入する.
- 一つ対一つ (1:1):エンティティ A の一つのインスタンスは、エンティティ B のちょうど一つのインスタンスに関連します。例:従業員はちょうど一つバッジを持ちます。
- 一つ対多数 (1:N):エンティティ A の一つのインスタンスは、エンティティ B の多数のインスタンスに関連します。例:部署は多数の従業員を雇用します。
- 多数対多数 (M:N):エンティティ A の多数のインスタンスは、エンティティ B の多数のインスタンスに関連します。例:学生は多数のコースに登録し、コースは多数の学生を有します。
2.2 多数対多数の関係の処理
リレーショナルデータベース設計において、直接の多数対多数の関係は物理的に実現できません。これは、関連エンティティ(ジョイントテーブルまたはブリッジテーブルとも呼ばれる)を導入することで解決する必要があります。
ビジネスルールが「部品は多数のアセンブリで使用され、アセンブリは多数の部品を含む”」の場合、変換には新しいエンティティが必要です。例えば「Assembly_Part_Usage」です。この新しいエンティティは、「Part」および「Assembly」エンティティからの外部キー、および数量のようなその関係に固有の属性を保持します。
2.3 任意性の決定
カーディナリティは単に数量に関するだけでなく、必要性についてもです。その関係は一致を必要としますか?
- 必須:関係は存在しなければなりません。例:注文には顧客が必須です。
- 任意:関係が存在するかどうかは任意です。例:顧客にミドルネームがあるかどうかは任意です。
この区別を文書化することで、null 値エラーを防ぎ、参照整合性制約が正しく適用されることを保証します。
ステップ 3: 正規化と制約の適用 ⚖️
初期図面がドラフトされた後、データを洗練させる必要があります。正規化とは、冗長性を減らし整合性を高めるためにデータを整理するプロセスです。これは単なる技術的な演習ではなく、ビジネスロジックの効率性の反映です。
3.1 第 1 正規形 (1NF)
すべての属性は原子値を含めなければなりません。繰り返しグループはあってはなりません。あるビジネスルールが次のように述べている場合「顧客は複数の電話番号を持つ」、それらを単一の列に次のように保存しないでくださいphone_numbers: '555-1234, 555-5678'。代わりに、電話番号のために別の行または関連するテーブルを作成してください。
3.2 第 2 正規形 (2NF)
属性は主キーに完全に依存している必要があります。エンティティが複合キーを持つ場合、どの属性もそのキーの一部のみには依存してはいけません。例えば、複合キーがStudent_IDとCourse_IDによって形成される場合、Student_Nameのような属性は履修登録テーブルに保存されてはいけません。それは学生テーブルに属します。
3.3 第 3 正規形 (3NF)
属性は他の非キー属性から独立している必要があります。これにより推移的依存性が排除されます。もしCityがZip_Codeに依存し、Zip_CodeがAddressの属性である場合、Cityは理想的には Address エンティティまたはリンクされた Zip_Code エンティティに保存され、複数のテーブルに重複して保存されてはいけません。
ステップ 4: ルールに対するモデルの検証 ✅
図が構築された後、検証を行う必要があります。このフェーズでは、技術モデルが元のビジネス要件から逸脱していないことを確認します。チェックリストはこの検証に効果的なツールです。
| ビジネスルールタイプ | ERDコンポーネント | 検証チェック |
|---|---|---|
| 一意性制約 | 主キー / 一意インデックス | すべてのエンティティは一意に識別可能か? |
| 必須リレーションシップ | NOT NULL制約 | 必要な場所に外部キーは必要か? |
| データ範囲 | チェック制約 / データ型 | 数値フィールドは期待されるビジネス制限と一致しているか? |
| 複数のリレーションシップ | 関連エンティティ | M:Nリレーションシップは1:Nリレーションシップに解決されているか? |
| 履歴データ | 時間的属性 | 変更の追跡に有効日付が含まれているか? |
この表を確認することでギャップを特定するのに役立ちます。例えば、ルールが「価格は負の値にできない」」と述べている場合、検証チェックはデータ型と制約がこのことを防ぐことを確認します。ルールが「製品はカテゴリに属しなければならない」」と述べている場合、検証チェックは外部キーがNULLでないことを保証します。
翻訳における一般的な落とし穴 🚧
経験豊富なモデラーでも、繰り返し発生する問題に直面することがあります。これらの一般的な落とし穴に気づくことで、開発フェーズで多くの時間を節約できます。
- 過剰な正規化:テーブルを細分化しすぎると、結合が過剰になり、クエリパフォーマンスが低下します。整合性とパフォーマンスの要件のバランスを取ってください。
- 属性の不足:リレーションシップに焦点を当てすぎて、エンティティに必要な記述データを忘れること。
- 1:1 関係を前提とすること:論理的な分離やセキュリティのために別テーブルであるべき 1:1 関係を単一のテーブルとして扱うこと。
- ソフトデリートを無視すること:ビジネスルールでは、非アクティブとマークされていても履歴のためにデータを保持する必要がある場合が多い。モデルは「
is_activeフラグまたは別のアーカイブテーブルを考慮する必要がある。 - 属性とエンティティを混同すること:ドメイン制約または列挙型値であるべきオプションのリスト(例:「ステータス」)をエンティティとして扱うこと。
ステップ 5:反復とドキュメンテーション 📝
データベース設計は線形プロセスであることはめったにありません。要件は進化し、初期モデルは調整を必要とする場合があります。ここでドキュメンテーションは極めて重要です。それは技術チームとビジネス関係者の間の架け橋として機能します。
5.1 データ辞書の維持
データ辞書はデータベースのメタデータを定義します。以下を含める必要があります:
- テーブル名:単数形または複数形の規約。
- 列名:明確な命名規約(例:「
customer_id対「cust_id). - データ型:整数、文字列、日付など。
- ビジネス定義:データが何を表すのかの平易な英語での説明。
- 制約:データに適用されるルール。
5.2 モデルのバージョン管理
アプリケーションコードと同様に、データモデルもバージョン管理されるべきです。スキーマの変更は追跡される必要があります。これにより、回帰が発生した場合、チームは当時のビジネスルールに合致していた以前の状態に戻すことができます。
整合性に関する最終的な考察 🎯
ビジネスルールからエンティティリレーションシップ図への変換は重要な分野です。これは関係者の話を聞き、そのニーズを技術的に解釈し、時代を超えて耐えうるモデルを構築することを要します。構造の良いデータベースは技術的負債を減らし、ビジネスの成長を支えます。
モデルがルールと整合すると、クエリは予測可能になり、レポートは正確になり、システムは保守しやすくなります。翻訳フェーズに投入された努力は、開発と保守の段階で利益をもたらします。すべての段階で明確さ、一貫性、検証に焦点を当ててください。
このフレームワークに準拠することで、チームは技術的には機能するが実際のビジネス運用をサポートできないというデータベース構築の一般的な罠を避けることができます。目標は単にデータを保存することではなく、意思決定を可能にする方法で情報を構造化することです。
フレームワークの概要 📋
- 分析:ビジネスルールを構造的、手続的、および状態型のタイプに分類します。
- 特定:エンティティには名詞を、属性には形容詞を抽出します。
- 接続:関係性をマッピングし、多対多のシナリオを解決します。
- 正規化:冗長性を削減するために、第1正規形(1NF)、第2正規形(2NF)、および第3正規形(3NF)を適用します。
- 検証:モデルを元のルールと照合して検証します。
- 文書化:生きているデータ辞書とバージョン管理を維持します。
この構造化されたアプローチにより、生成されるデータベーススキーマは単なるテーブルの集合ではなく、組織のロジックと目標を反映したものになります。これは抽象的な要件を効率を推進する具体的な資産へと変換します。