
Concevoir une structure de données robuste est le fondement de toute application fiable. Au cœur de cette conception se trouve le diagramme entité-association (ERD), où la distinction entre les types d’entités dicte la manière dont les données sont stockées, reliées et récupérées. Comprendre les nuances entre les entités faibles et fortes n’est pas seulement académique ; cela détermine l’intégrité de votre cycle de vie des données. Ce guide propose un examen détaillé de ces concepts, en se concentrant sur la mise en œuvre pratique et la logique structurelle.
Définition de l’entité forte 💪
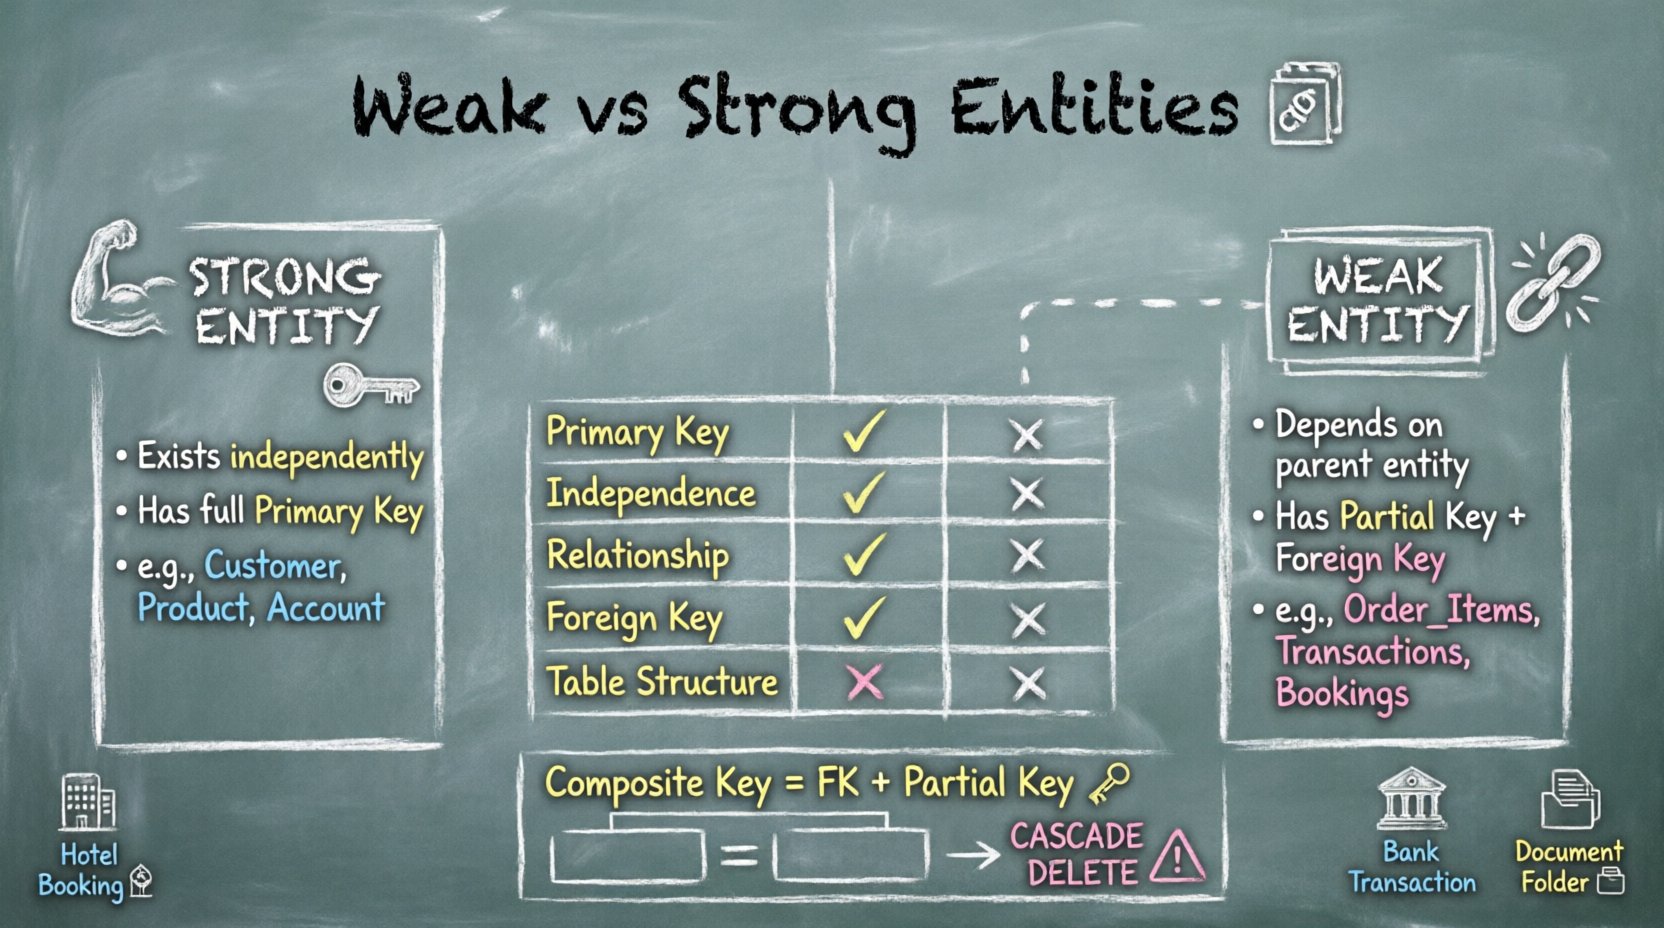
Une entité forte, souvent appelée entité régulière, représente un objet ou un concept distinct qui existe indépendamment au sein de la base de données. Elle possède sa propre identité unique, qui ne dépend pas de l’existence d’une autre entité. En termes de modélisation, une entité forte peut être identifiée de manière unique par une clé primaire qui lui est intrinsèque.
Caractéristiques des entités fortes
- Existence indépendante : Un enregistrement pour une entité forte peut exister sans enregistrement parent. Par exemple, un Client peut exister dans une base de données même s’il n’a jamais passé de commande.
- Identifiant unique : Chaque instance de l’entité doit avoir une clé primaire qui garantit l’unicité dans toute la table. Il s’agit souvent d’un entier auto-incrémenté ou d’un UUID.
- Stabilité structurelle : Le schéma d’une entité forte reste généralement stable au fil du temps, car il représente des objets métier fondamentaux plutôt que des données transitoires.
Considérons un scénario impliquant un système d’inventaire. L’entité Produit est forte. Une définition de produit existe dans le catalogue, qu’une instance spécifique soit actuellement en stock ou associée à un emplacement d’entrepôt spécifique. Le produit possède son propre identifiant, disons product_id, qui sert de clé primaire.
Définition de l’entité faible ⛓️
Une entité faible est une entité qui ne peut pas être identifiée de manière unique par ses propres attributs seuls. Elle dépend d’une entité parente pour son identité. Sans l’entité parente, un enregistrement d’entité faible n’a aucun sens ni contexte. En modélisation de base de données, cette dépendance est cruciale pour maintenir l’intégrité référentielle.
Caractéristiques des entités faibles
- Dépendance d’existence : L’existence d’un enregistrement d’entité faible est conditionnée par l’existence d’un enregistrement d’entité forte spécifique. Si le parent est supprimé, l’entité faible enfant doit également être supprimée.
- Clé partielle : Les entités faibles n’ont pas de clé primaire complète. À la place, elles possèdent une clé partielle (également appelée discriminateur) qui est unique uniquement dans le contexte de l’entité parente.
- Relation d’identification : La connexion entre une entité faible et son parent fort est une relation d’identification. Cette relation est obligatoire et est généralement représentée par une double ligne dans la notation ERD.
Prenons l’exemple de Order_Items. Un article de commande ne peut pas exister sans un Commande. De plus, un article de commande n’est pas défini uniquement par son identifiant interne propre, mais par la commande à laquelle il appartient. Un article de ligne spécifique peut être le premier article d’une commande et le deuxième article d’une autre. L’unicité de l’article de ligne découle de la combinaison de l’Order_ID et d’un numéro de séquence tel que line_number.
Comparaison des structures fortes et faibles 📊
Visualiser les différences aide à appliquer les techniques de modélisation appropriées. Le tableau suivant décrit les distinctions techniques entre les deux types d’entités.
| Caractéristique | Entité forte | Entité faible |
|---|---|---|
| Clé primaire | Clé primaire complète (Identifiant unique) | Clé partielle (Discriminant) |
| Indépendance | Existe de manière indépendante | Dépend de l’entité forte |
| Type de relation | Non identifiant (Optionnel) | Identifiant (Obligatoire) |
| Clé étrangère | Non requis pour l’identité | Requis pour l’identité |
| Structure de table | Table standard | Souvent fusionnée ou liée via une clé étrangère |
Attributs identifiants et clés partielles 🔑
Le concept de clé partielle est central pour comprendre les entités faibles. Dans une entité forte, la clé primaire est unique pour toutes les instances de cette entité. Dans une entité faible, la clé partielle n’est unique que dans le périmètre de l’instance parente spécifique.
Construction de la clé composite
Pour implémenter une entité faible dans une base de données physique, le système de gestion de base de données crée généralement une clé primaire composite. Cette clé se compose de deux parties :
- La clé étrangère : Cela fait référence à la clé primaire de l’entité parente forte.
- La clé partielle : C’est l’attribut local qui différencie les instances de l’entité faible les unes des autres au sein du parent.
Par exemple, dans un schéma pour unProjet etTâches_Projet relation :
project_id(Clé étrangère provenant de Projet)task_sequence(Clé partielle)
L’identifiant unique d’une tâche est la combinaison deproject_id ettask_sequence. Une tâche avec le numéro de séquence 1 dans le Projet A est distincte d’une tâche avec le numéro de séquence 1 dans le Projet B. Cette structure composite garantit que les données restent cohérentes et évite toute ambiguïté.
Relations et Cardinalité ⚖️
La relation entre les entités fortes et faibles n’est pas seulement un concept logique ; elle dicte les contraintes de cardinalité et d’optionnalité dans le MCD.
Participation Obligatoire
Parce qu’une entité faible ne peut pas exister sans son parent, la participation de l’entité faible dans la relation est obligatoire. En termes de modélisation, cela est souvent représenté par une double ligne reliant la relation à l’entité faible. Cela signifie que vous ne pouvez pas créer un enregistrement dans la table enfant sans un enregistrement parent valide correspondant.
Intégrité Référentielle
Mettre en œuvre cette relation dans une base de données nécessite des contraintes strictes d’intégrité référentielle. Lorsque l’entité forte est supprimée, le moteur de base de données doit gérer les entités faibles. Cela est couramment réalisé grâce àSUPPRESSION EN CASCADE actions. Si le parent est supprimé, toutes les entités faibles dépendantes sont automatiquement supprimées pour éviter les enregistrements orphelins.
Cette logique prévient la corruption des données. Imaginez un scénario où uneFacture est supprimée, mais lesLignes_Facture restent. Les lignes orphelines feraient référence à une facture inexistante, créant des anomalies de données difficiles à déboguer et à interroger.
Bonnes pratiques de conception 🛠️
L’application correcte de ces concepts nécessite le respect de directives de modélisation spécifiques. S’en écarter peut entraîner des problèmes de performance et des incohérences de données.
1. Évitez les entités faibles inutiles
Toutes les relations qui semblent dépendantes ne doivent pas être modélisées comme des entités faibles. Si une entité a un sens en soi, elle doit être une entité forte. Par exemple, un employé et un dépendantpourrait sembler dépendant, mais un dépendant pourrait exister indépendamment d’un enregistrement d’emploi spécifique dans certains contextes. Une analyse minutieuse des règles métier est requise.
2. Assurez-vous de conventions de nommage claires
Puisque les entités faibles reposent sur des clés étrangères pour leur identité, les conventions de nommage doivent refléter cette dépendance. L’utilisation de préfixes ou de suffixes comme _ligne, _article, ou _détailpeut aider les développeurs et les analystes à identifier rapidement la nature de la relation.
3. Stratégies d’indexation
Les clés primaires composites dans les entités faibles nécessitent des stratégies d’indexation spécifiques. La composante de clé étrangère doit être indexée pour accélérer les jointures. Dans de nombreux systèmes, la clé composite entière constitue l’index, ce qui facilite la récupération mais peut impacter les performances d’écriture si la clé partielle n’est pas séquentielle.
4. Considérations de normalisation
Les entités faibles apparaissent souvent dans le contexte de la troisième forme normale (3NF). En isolant les attributs dépendants dans une table séparée liée par une relation d’identification, vous éliminez les dépendances transitives. Cela garantit que les modifications apportées à l’entité parente ne nécessitent pas de mises à jour de plusieurs lignes dans la table enfant.
Pièges courants de modélisation ⚠️
Même des concepteurs expérimentés peuvent commettre des erreurs lors de la manipulation des types d’entités. La conscience de ces pièges peut faire gagner un temps considérable de refactoring plus tard.
Piège : Traiter une entité faible comme une entité forte
Si vous attribuez une clé primaire autonome à une entité faible (comme un ID auto-incrémenté), vous brisez la logique de dépendance. Cela permet à l’entité faible d’exister sans parent, violant ainsi la règle métier. Cela complique également la logique nécessaire pour récupérer les données associées.
Piège : Ignorer les suppressions en cascade
Définir la relation sans gérer la logique de suppression peut entraîner des erreurs de base de données. Si le parent est supprimé et que la contrainte de clé étrangère l’empêche, l’application plantera. Si le parent est supprimé mais que l’enfant subsiste, les données deviennent orphelines. Le schéma doit définir explicitement le comportement pour la suppression du parent.
Piège : Clés partielles ambiguës
Une clé partielle doit être véritablement unique au sein du parent. Si une clé partielle est réutilisée pour différents parents sans le contexte de la clé étrangère, la clé composite perd son unicité. Cela se produit souvent lors de l’utilisation de compteurs simples (1, 2, 3) sans vérifier que la portée est limitée à l’enregistrement parent.
Scénarios d’application dans le monde réel 🌍
La compréhension de ces concepts devient plus claire lorsqu’ils sont appliqués à des domaines spécifiques. Voici des scénarios courants où les entités faibles sont le choix approprié.
1. Systèmes de réservation d’hôtels
Dans une base de données d’hôtel, un Chambre pourrait être considéré comme une entité forte (la chambre 101 existe toujours). Cependant, une Réservation_de_chambre est une entité faible. Un enregistrement de réservation n’a aucun sens sans une chambre spécifique et une date spécifique. La réservation est identifiée de manière unique par le ID_chambre et le Date.
2. Transactions financières
Considérons un système de compte bancaire. Un Compte est une entité forte. Un Transactionau sein de ce compte est une entité faible. Bien qu’une transaction puisse avoir un identifiant de transaction, son contexte est entièrement défini par le compte auquel elle appartient. Un identifiant de transaction 500 dans le Compte A est différent de l’identifiant de transaction 500 dans le Compte B.
3. Gestion de documents
Dans un dépôt de documents, un Dossier est une entité forte. Un Documentà l’intérieur du dossier est souvent modélisé comme une entité faible par rapport à la hiérarchie des dossiers. Le chemin d’accès et la visibilité du document dépendent de la structure des dossiers.
Implémentation et Évolution 🔄
Les schémas de base de données sont rarement statiques. À mesure que les exigences métier évoluent, la distinction entre entités faibles et fortes peut changer.
Refactoring des dépendances
Avec le temps, une entité faible peut gagner suffisamment d’indépendance pour devenir une entité forte. Par exemple, un Ticket_de_soutien peut initialement être faible par rapport à un Utilisateur. Cependant, si le système évolue pour permettre des tickets anonymes ou des tickets liés à plusieurs utilisateurs, l’entité devra peut-être être refactorisée en une entité forte avec une nouvelle clé primaire.
Implications en matière de performance
Une imbrication profonde d’entités faibles (une entité faible d’une entité faible) peut impacter les performances des requêtes. Chaque niveau ajoute une exigence de jointure. Il est conseillé de maintenir une hiérarchie aussi plate que possible. Si une relation est profondément imbriquée, envisagez de dénormaliser les données pour les opérations fortement orientées lecture, à condition que l’intégrité des données puisse être maintenue.
Conclusion sur l’intégrité des données 🛡️
La décision de modéliser une entité comme faible ou forte est un choix architectural fondamental. Elle affecte la manière dont les données sont interrogées, dont les relations sont appliquées et dont le système gère les suppressions. En adhérant strictement aux règles des relations d’identification et des clés composites, vous garantissez que votre base de données reste une source de vérité fiable. Cette discipline empêche l’accumulation de données orphelines et simplifie la maintenance du système à mesure qu’il évolue.
Lors de l’examen de vos diagrammes entité-association (ERD), demandez-vous si l’entité peut exister sans son parent. Si la réponse est non, modélisez-la comme une entité faible. Si la réponse est oui, traitez-la comme une entité forte. Cette logique binaire, appliquée de manière cohérente, constitue le socle d’un schéma de base de données bien structuré.