

堅牢なデータベーススキーマを設計するには、単にテーブルや列を列挙するだけでは不十分です。エンティティ間の関係性を深く理解することが求められます。エンティティ・リレーションシップ図(ERD)の中で最も強力でありながら複雑な概念の一つが継承です。このメカニズムにより、共通の特性を持ちつつも固有の属性を備えた現実世界の階層をモデル化することができます。データベース設計の文脈では、これはスーパータイプとサブタイプとして表現されます。🧩
継承をモデル化する際、私たちは本質的に「~である」という関係性を捉えています。例えば、車両は製品であり、自動車は車両この階層構造により、上位レベルで属性を再利用しつつ、下位レベルで特定の振る舞いやデータを定義することができます。これをリレーショナルデータベースでどのように実装するかを理解することは、データの整合性とクエリパフォーマンスにとって極めて重要です。🗄️
🔑 核心概念:スーパータイプとサブタイプ
実装に着手する前に、用語を明確に定義する必要があります。データベースモデリングにおける継承は、単にコードに関するものではなく、データの構造的表現に関するものです。
- スーパータイプ:これは親エンティティです。関連するすべてのエンティティに共通する属性を含みます。一般的なカテゴリを表します。例えば、従業員がスーパータイプとなり得ます。
- サブタイプ:これらは子エンティティです。スーパータイプから属性を継承しますが、独自の固有属性を持つこともあります。例として、マネージャーや開発者.
- エンティティカテゴリ:スーパータイプは、場合によってはエンティティカテゴリとも呼ばれ、サブタイプをグループ化します。
- ディスクリミネータ:スーパータイプ内の特定の属性で、インスタンスがどのサブタイプに属するかを識別します。これは物理的な実装でよく使用されます。
スーパータイプとサブタイプの間の関係は厳格です。サブタイプのすべてのインスタンスは、必ずスーパータイプのインスタンスでもあります。ただし、スーパータイプのすべてのインスタンスが特定のサブタイプのインスタンスである必要はありません。この区別は、データモデリングの正確さにとって不可欠です。✅
📊 実装戦略
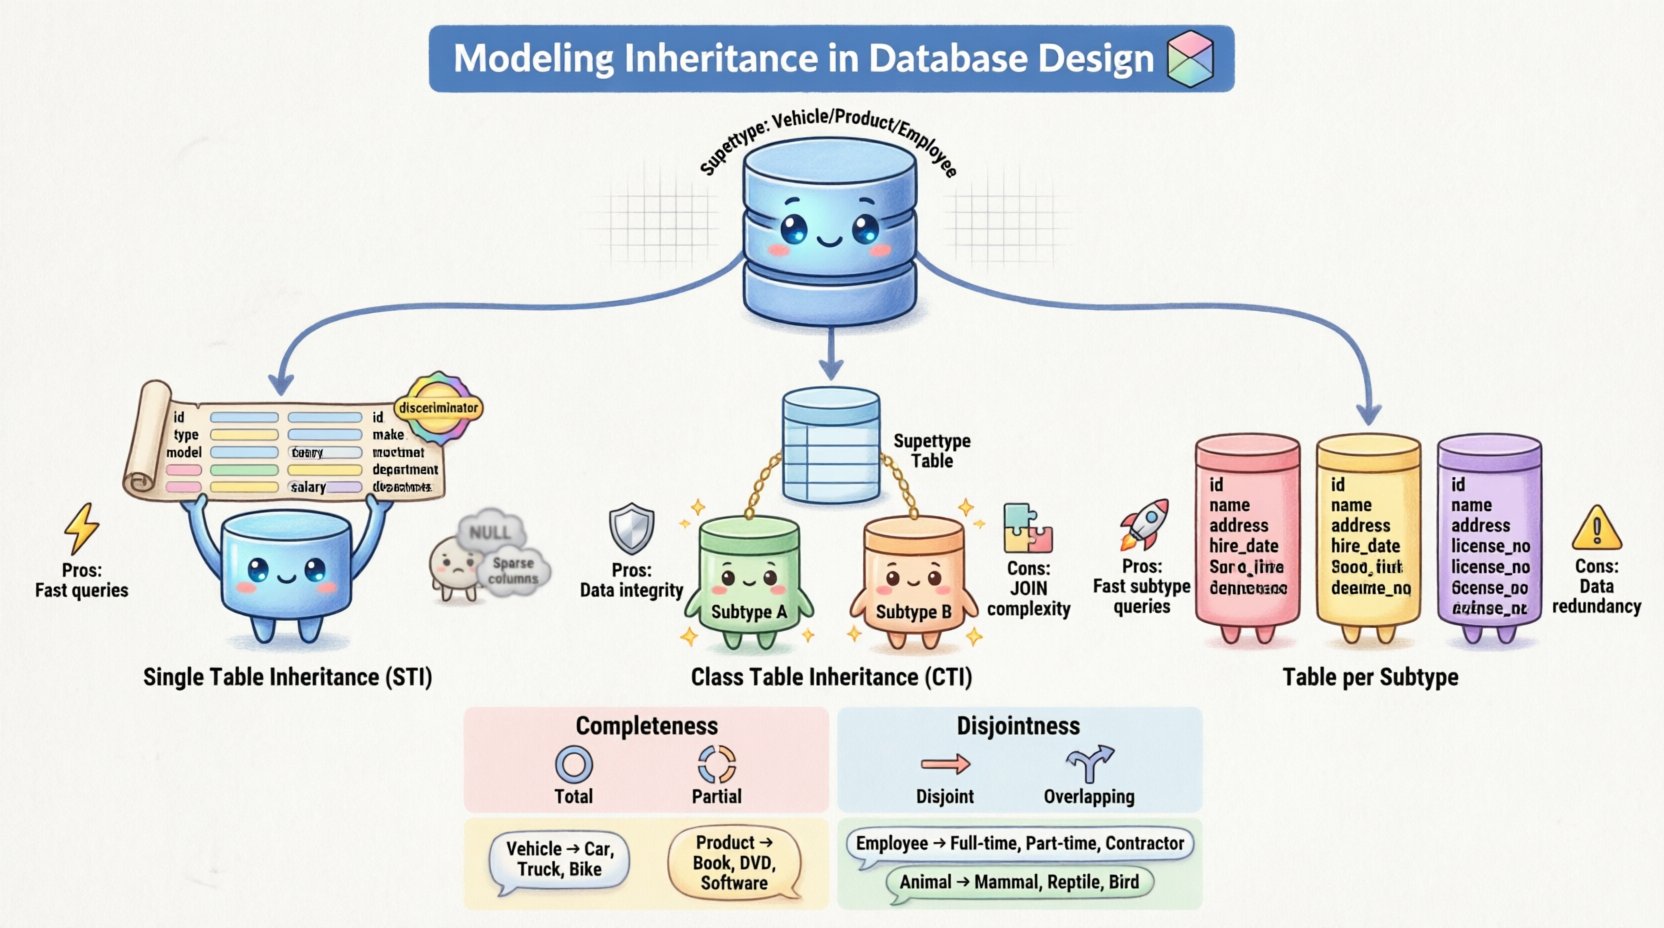
論理的な ERD モデルを物理的なデータベーススキーマに変換するには、特定のマッピング戦略が必要です。リレーショナルシステムで継承を表現するために使用される主なアプローチは 3 つあります。それぞれに、ストレージ、検索速度、データの整合性に関するトレードオフがあります。🛠️
1. 単一テーブル継承 (STI)
このアプローチでは、スーパータイプとすべてのサブタイプのすべての属性が単一のテーブルに統合されます。このテーブルには、階層全体で定義されたすべての属性に対応する列が含まれます。異なるサブタイプに属する行を区別するために、ディスクリミネータ列が追加されます。
- 利点: データの読み取りに極めて効率的です。単純な
SELECTにより、複雑な結合なしですべての情報を取得できます。 - 欠点: テーブルが非常に広くなり、特定のサブタイプに適用されない属性に対して多くの
NULL値が生じます。また、サブタイプ固有の制約が変更された場合、更新が困難になることもあります。
2. クラステーブル継承 (CTI)
ここでは、スーパータイプと各サブタイプがそれぞれ独立したテーブルにマッピングされます。スーパータイプテーブルには共通属性と主キーが含まれます。各サブタイプテーブルには固有の属性と、スーパータイプの主キーへの外部キーが含まれます。
- 利点: 高度に正規化されています。適用されない属性に対する
NULL値がありません。参照整合性が厳格に強制されます。 - 欠点: データの取得には複数の
JOIN操作が必要となり、大規模データセットではパフォーマンスに影響を与える可能性があります。また、INSERT操作も複雑化します。データは複数のテーブルに書き込む必要があるためです。
3. サブタイプごとのテーブル(具体テーブル継承)
この戦略では、スーパータイプを含むすべてのサブタイプごとにテーブルが作成されます。ただし、各サブタイプテーブルにはスーパータイプの属性のコピーが含まれます。中央のスーパータイプテーブルへの直接的なリンクはありません。
- 利点: 特定のサブタイプへの照合は、すべてのデータが1か所に存在するため非常に高速です。これは
NULL問題(STIの欠点)を回避します。 - 欠点: データの重複。スーパータイプで共通属性が変更された場合、すべてのサブタイプテーブルで更新する必要があります。これにより、データの不整合のリスクが高まります。
⚖️ 継承に関する制約
すべての継承関係が同じであるわけではありません。インスタンスがその型とどのように関連するかを支配する制約を定義する必要があります。これらの制約により、データが論理的かつ一貫したまま保たれます。📝
完全性制約
この制約は、すべての超タイプ(上位型)のインスタンスがサブタイプ(下位型)に属する必要があるかどうかを決定します。
- 完全: 超タイプのすべてのインスタンスは、少なくとも一つのサブタイプのメンバーでなければなりません。「一般的な」インスタンスは存在しません。例えば、すべての動物は、哺乳類または鳥.
- 部分的:超タイプのインスタンスは、必ずしもどのサブタイプにも属するわけではありません。それは一般的なエンティティとして存在できます。これは、階層が厳密な分類ではなく分類のために使用される場合に一般的です。
相違制約
この制約は、一つのインスタンスが同時に複数のサブタイプに属する可能性があるかどうかを決定します。
- 相違:インスタンスは一つのサブタイプにのみ属することができます。マネージャーと開発者の両方であることは、このモデル内では同時にできません。
- 重複:インスタンスは複数のサブタイプに属することができます。これにより、従業員が複数の役職や分類を保持できるような複雑な役割が可能になります。
これらの制約を組み合わせると、4 つの明確なモデリングシナリオが生まれます。スキーマを作成する前に、どのシナリオがあなたのビジネスロジックに適合するかを理解することが極めて重要です。🧠
| 制約の種類 | 定義 | 例のシナリオ |
|---|---|---|
| 排他的 + 完全 | サブタイプは 1 つのみ、汎用インスタンスなし | 注文ステータス:保留中、発送済み、配送完了 |
| 排他的 + 部分的 | サブタイプは 1 つのみ、サブタイプは任意 | 顧客:VIP または一般(一部はどちらでもない) |
| 重複 + 完全 | 複数のサブタイプを許可、ただし 1 つに所属すること必須 | ユーザーロール:管理者と編集者(少なくとも 1 つは必須) |
| 重複 + 部分的 | 複数のサブタイプを許可、任意 | 製品:販売可能、プロモーション対象(両方でもどちらでもないでも可) |
🔍 クエリとデータ取得
マッピング戦略の選択は、クエリの書き方に大きな影響を与えます。正規化された環境では、エンティティの完全な像を把握するために、階層をたどる必要があることがよくあります。🔎
- サブタイプデータの取得:サブタイプ固有の属性にアクセスする必要がある場合、サブタイプテーブルを結合する必要があります。これはクラステーブル継承(CTI)の標準的な手法です。
- スーパータイプデータの取得:共通属性が必要な場合、スーパータイプテーブルを直接クエリできます。
- 多相クエリ:サブタイプに関係なくすべてのインスタンスをクエリする場合、単一テーブル方式が最速です。ただし、複数のテーブルを使用する場合は、
UNION演算子または複雑な結合を使用する必要があります。
パフォーマンスへの影響を考慮してください。1 つのレコードを取得するために 5 つのテーブルを結合するクエリは、非正規化された単一テーブルに対するクエリよりも遅くなる可能性があります。ただし、非正規化されたテーブルは正規化ルールに違反し、更新異常を引き起こす可能性があります。これらの要因のバランスを取ることが、スキーマ設計の重要な部分です。⚖️
🛠️ 保守と進化
スキーマは静的ではありません。ビジネス要件は変化するため、データベース構造も変化しなければなりません。継承モデルは柔軟性を提供しますが、保守中に複雑さを導入することにもなります。🔄
新しいサブタイプの追加
新しいサブタイプの追加は一般的に簡単です。CTI の場合は新しいテーブルを作成し、STI の場合はディスクリミネータ列に新しい値を追加します。ただし、既存のクエリとアプリケーションロジックが新しいタイプに対応していることを確認する必要があります。コードの更新を怠ると、ランタイムエラーが発生する可能性があります。
スーパータイプ属性の変更
スーパータイプに属性を追加した場合、CTI またはサブタイプごとのテーブル方式を使用している場合、その属性はすべてのサブタイプテーブルに反映されなければなりません。STI の場合は、単一のテーブルに 1 回追加するだけで済みます。これにより、共通の変更については STI の方が保守が容易になりますが、特定の変更については保守が難しくなります。
データ移行
継承モデルのリファクタリングは大きな作業です。単一のテーブルから正規化された構造へ移行するには、データを複数のテーブルに移動する必要があります。このプロセスは、データの損失や破損を防ぐために慎重に管理されなければなりません。🚧
📈 正規化と継承
継承モデルはデータベース正規化と密接に関係しています。正規化の目的は冗長性を減らし、データの整合性を高めることです。継承は、適切に処理されない場合、これらの目的と衝突することがあります。
- 第一正規形 (1NF):継承モデルは、属性が原子性であるため、一般的に 1NF を満たします。
- 第二正規形 (2NF):STI(単一テーブル継承)では、識別子がキーの一部でない場合、テーブルに主キーに完全に依存しない属性が含まれる可能性があります。これには慎重なキー設計が必要です。
- 第三正規形 (3NF):CTI(共通テーブル継承)では、属性をサブタイプテーブルに分離することで、推移的依存関係を排除し、3NF を達成しやすくなります。
スーパータイプを設計する際は、共通属性が本当に共通していることを確認してください。ある属性がサブタイプのうち一つだけでしか使用されない場合、それはスーパータイプに含まれるべきではありません。これにより、スーパータイプがクエリが困難な「神のテーブル」になるのを防ぎます。👁️
🎯 スキーマ設計のベストプラクティス
継承モデルが保守可能でパフォーマンスが高い状態を維持するために、以下のガイドラインに従ってください。
- 深さを制限する:深い階層を避けてください。継承レベルは通常、3 段階が推奨される最大値です。これを超えると、クエリと保守の複雑さがメリットを上回ってしまいます。
- 明確な命名を使用する:名前は階層を反映すべきです。Vehicle, Car, Truckは明確です。Entity1, Entity2ではありません。
- 成長を見据えて計画する:将来のサブタイプを見込んでください。多くの新しいサブタイプが予想される場合、単一のテーブルは扱いにくくなる可能性があります。少数と予想される場合は、CTI の方が適しているかもしれません。
- 制約を文書化する:不交性と完全性の制約を明確に文書化してください。将来の開発者は、インスタンスが複数のサブタイプに属する可能性があるかどうかを知る必要があります。
- インデックス戦略:CTI を使用する場合は、結合を高速化するためにサブタイプテーブルの外部キー列にインデックスを作成します。STI を使用する場合は、フィルタリングのために識別子列にインデックスを作成します。
🧪 実世界のシナリオ
これが実際のデータモデリングの課題にどのように適用されるかを見てみましょう。
シナリオ 1: 人事
人事システムでは、Personをスーパータイプとして持っています。サブタイプにはEmployee, Contractor、およびInternが含まれます。各サブタイプには固有のデータがあります:Employeeには給与番号があり、Contractorには請求単価があります。Personテーブルには名前と住所が格納されます。これはクラステーブル継承モデルにうまく適合します。
シナリオ 2: 在庫管理
製品カタログを考えてみましょう。Productがスーパータイプです。サブタイプはElectronics, Furniture、およびClothing. 電子機器 は 保証期間. 衣類 は サイズ と 色。保証付きの全製品を検索する場合は、電子機器テーブルを結合する必要があります。これはクエリパフォーマンスのトレードオフを浮き彫りにしています。🔍
シナリオ 3:金融取引
銀行システムでは、口座がスーパータイプです。サブタイプは普通預金, 小切手口座、および貸付。普通預金口座には金利があります。貸付口座には返済期限があります。このシナリオでは、すべての口座タイプにわたる残高計算を簡素化するために、単一テーブル方式がしばしば有効です。
🚀 パフォーマンスの考慮事項
マッピング戦略を選択する際、パフォーマンスはしばしば決定的な要因となります。大規模なデータセットでは、アプローチ間の違いがより顕著になります。
- 書き込みパフォーマンス: STI は、単一の
INSERT文です。CTI は複数のINSERT文は、トランザクションのオーバーヘッドを増加させます。 - 読み取りパフォーマンス:特定のサブタイプを頻繁に照会する場合、CTI は STI よりも高速です。これは関連する列のみを読み取るためです。すべてのインスタンスを照会する場合、STI の方が高速です。
- ストレージ:STI は、
NULLパディングのため、より多くのストレージを使用します。CTI は、重複する主キーと外部キーのためにより多くのストレージを使用しますが、NULLパディングがないため、より少ないストレージを使用します。
アプリケーションのプロファイリングは不可欠です。理論的なパフォーマンスは、必ずしも実際の使用パターンと一致するわけではありません。現実的なデータ量でテストを行うことが、選択を確認する唯一の方法です。📊
🛡️ データ整合性と検証
継承モデルでデータ整合性を維持するには、厳格な検証ルールが必要です。サブタイプテーブルに入力されたデータが、スーパタイプの制約と一致していることを確認しなければなりません。
- 外部キー制約:サブタイプ行が常に有効なスーパタイプ行にリンクしていることを確認してください。これにより、孤立したデータが防止されます。
- チェック制約:ビジネスルールを強制するためにチェック制約を使用してください。例えば、金利が普通預金サブタイプで常に負にならないことを確認してください。
- トリガー:一部の複雑なシナリオでは、更新時にテーブル間の一貫性を維持するためにデータベーストリガーが必要になる場合があります。
自動テストは継承シナリオをカバーすべきです。新しいサブタイプインスタンスを作成すると、スーパタイプが正しく更新されることを確認してください。スーパタイプインスタンスを削除すると、それが意図された動作である場合、サブタイプに正しくカスケードされることを確認してください。🧪
📝 最終的な考慮事項
継承のモデリングは、柔軟性と複雑さの間のバランスを取る行為です。それを正しく行うための単一の「正しい」方法はありません。最適な選択は、特定のデータアクセスパターン、ビジネスルール、パフォーマンス要件に依存します。
- ドメインを明確に理解することから始めてください。テーブルについて心配する前に、エンティティのマッピングを行ってください。
- 最も頻繁な照会と一致するマッピング戦略を選択してください。
- 意思決定を文書化してください。将来の保守はこの文書に依存します。
- スキーマを定期的にレビューしてください。ビジネスが進化するにつれて、モデルを変更する必要があるかもしれません。
スーパータイプとサブタイプを慎重に設計することで、堅牢でスケーラブル、かつ理解しやすいデータベースを作成できます。この基盤は、それを利用するアプリケーションを支え、長期的な安定性と効率性を保証します。🏗️