

効果的なデータモデリングは、堅牢なアプリケーションアーキテクチャの基盤です。チームがデータベーススキーマで共同作業を行う際、エンティティ関係図(ERD)は唯一の真実の源として機能します。しかし、標準化されたドキュメンテーションの慣行がなければ、これらの図は明確さの源ではなく、混乱の源となることがよくあります。構造の曖昧さは、一貫性のない開発、バグの増加、デプロイサイクルの遅延につながります。このガイドでは、シームレスなチームワークをサポートするERDドキュメンテーションを作成するための必須標準規格を概説します。
データモデリングは単に箱や線を描くことではありません。それはデータベース管理者、バックエンドエンジニア、プロダクトマネージャー間のコミュニケーションプロトコルです。全員が同じ視覚的言語を話せば、誤解のリスクは大幅に低下します。以下のセクションでは、高品質なドキュメンテーションを維持するために必要な構造的、構文的、および手続的な標準規格を詳述します。
📝 基礎的な命名規則
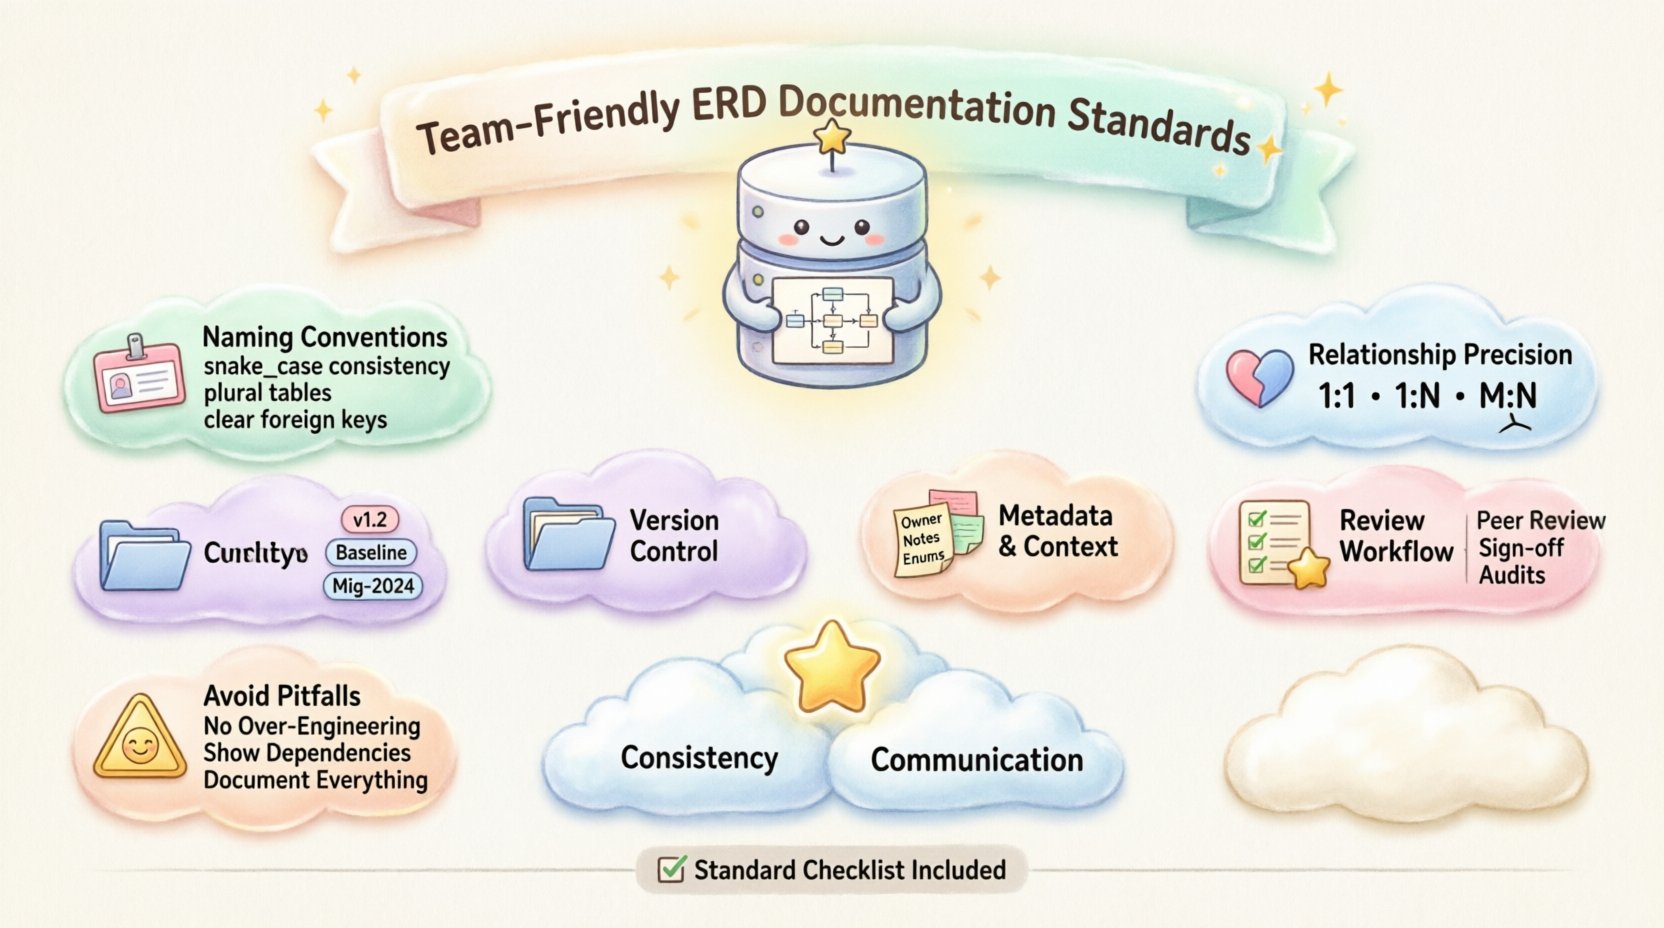
命名規則は、あらゆるドキュメントセットにおける明確さの第一層を形成します。一貫性のない命名は認知的な摩擦を生み出します。スキーマを読む開発者は、列名が何を表すかを推測する必要はありません。標準化により、プロジェクト全体で名前が予測可能になります。
- 一貫性が鍵です:組織全体で単一のスタイルガイドを採用してください。snake_case、camelCase、PascalCaseのいずれを選択する場合でも、その決定は一度行われ、普遍的に適用されるべきです。
- 複数形 vs. 単数形:テーブルは通常、エンティティのコレクションを表すため、複数形の命名(例:”
users,orders) がよく好まれます。それらのテーブル内の列は単数形であるべきです(例:”user_id,order_date). - 外部キーの明確さ:関係を明示的に命名することは理解を助けます。”テーブルを参照する列は、理想的には”という名前であるべきです。
usersテーブル”は、理想的には”という名前であるべきです。user_idではなく、単に”という名前です。id。これにより、その関係がどのテーブルに属するかという曖昧さがなくなります。 - 特殊文字:テーブル名や列名にスペースや特殊文字は避けてください。これらはSQLクエリで引用符が必要となり、自動化ツールでエラーの原因となります。代わりにアンダースコアまたはcamelCaseを使用してください。
- 大文字小文字の区別:基盤となるデータベースエンジンに注意してください。一部のシステムは大文字小文字を区別しますが、そうでないものもあります。標準的な大文字小文字のスタイルを文書化することで、異なる環境間でのデプロイの問題を防ぎます。
命名が長期的な保守に与える影響を考慮してください。システムが成長するにつれて、新しい開発者がチームに加わります。明確な名前は、データ構造を理解するために必要なオンボーディング時間を削減します。曖昧であるよりも冗長である方がよいでしょう。”のような名前は顧客の主要メールアドレス は より明確ですcp_email、後者が短い場合でも。
🔗 関係性を精密に定義する
エンティティ間の関係性はデータモデルの整合性を定義します。ERD(エンティティリレーションシップ図)は、データポイントがどのように接続されるかを明確に伝達しなければなりません。あいまいな線や欠落したラベルは、実装時に誤りと判明することが多い推測につながります。
カーディナリティ表記
カーディナリティは、エンティティ間の数値的な関係性を記述します。図で使用される表記を標準化することで、誤解を防ぎます。
- 一つ対一つ (1:1):あるテーブルのレコードが、もう一つのテーブルのちょうど一つのレコードに対応することを示します。これは、機密データの分離や特定のプロフィール拡張によく見られます。
- 一つ対多数 (1:N):最も一般的な関係性です。親テーブルのレコード一つが、子テーブルの複数のレコードに関連します。例えば、一つの
顧客が複数の注文. - 多数対多数 (M:N):中間の結合テーブルが必要です。これは、ブリッジエンティティなしで論理モデルにおいて直接の線として決して表現されてはいけません。構造を明確にするために、結合テーブルを明示的に示してください。
任意性と制約
すべての関係性が必須であるわけではありません。図は、関係性が任意か必須かを示す必要があります。
- 必須参加:子テーブルのすべてのレコードは親を持たなければなりません。例えば、すべての
行項目は注文. - 任意参加:レコードは親なしで存在する可能性があります。例えば、
ユーザープロフィールには、リンクされた支払い方法登録直ちに。
ここでは視覚的表記が重要です。これらの制約を示すために、特定の記号(例えば、カラスの足や特定の線終端記号など)を使用してください。ルールを説明するためにテキストだけに頼らないでください。視覚的表現は、技術者にとって自己完結的で理解しやすいものであるべきです。
📂 データベーススキーマのバージョン管理
アプリケーションコードにバージョン管理が必要であるのと同様に、データベーススキーマにもバージョン管理が必要です。ドキュメントは静的な成果物ではなく、システムとともに進化します。変更を追跡するプロセスがなければ、図は必然的に実際のデータベース状態から乖離していきます。
- 変更ログ:ERD に対するすべての変更は記録されるべきです。これには、日付、作成者、変更の種類、および変更の理由が含まれます。
- ベースラインバージョン:特定のリリースに対してベースラインを確立してください。機能が開発されている場合、ドキュメントはその機能に必要なスキーマの状態を反映すべきです。
- マイグレーション追跡:ドキュメントをマイグレーションスクリプトと関連付けてください。列が追加された場合、ドキュメントはその変更を実装するマイグレーションスクリプトを参照すべきです。
- 競合解決:複数のチームがスキーマを変更する場合、バージョン管理戦略によって上書きを防ぐことができます。各スキーマセグメントの所有者を特定し、意図しない競合を回避してください。
時間の経過とともに図の整合性を維持することは不可欠です。時代遅れの図は、図がないことよりも悪く、それは誤った安心感を生み出します。チームはもはや存在しない情報に基づいて機能を構築する可能性があります。
📄 メタデータと文脈情報
技術的な詳細だけでは不十分です。ドキュメントには、意思決定の文脈を提供するメタデータを含める必要があります。なぜ特定の設計選択がなされたのか?このデータの所有者は誰か?
所有権と管理責任
特定のテーブルまたはスキーマに対して所有権を割り当ててください。これにより、質問や変更について誰に連絡すべきかが明確になります。
- データ管理者:テーブル内のデータの正確性を責任を持つ個人を特定してください。
- 技術所有者:スキーマ構造の保守を責任を持つリードエンジニアを特定してください。
- ビジネスオーナー:データの要件を定義する製品担当者またはビジネス関係者を特定してください。
説明的注記
複雑なビジネスロジックは、線だけでは表現できないことがよくあります。特定のルールを説明するために注記を追加してください。
- 計算ロジック:列が計算値である場合、使用された数式を文書化してください。
- 列挙型値:値の制限されたセットを持つ列の場合(例:
ステータス)、許可された値とその意味をリストしてください。 - 非推奨フィールド:使用されなくなったフィールドを明確にマークしてください。非推奨となった時期と削除予定時期を明記してください。
この文脈は、技術的な図をビジネス資産に変えます。新しいチームメンバーが「何」の背後にある「なぜ」を理解するのに役立ちます。
🔄 審査と承認のワークフロー
標準を強制するプロセスがなければ、標準は無意味です。審査ワークフローを確立することで、ドキュメントが正確であり、プロジェクトの目標と整合していることを保証します。
- ピアレビュー:スキーマ変更をマージする前に、少なくとも1人のピアレビューを必須とします。これにより、命名の不一致やロジックエラーを検出できます。
- 利害関係者の承認:主要な構造変更については、ビジネスの利害関係者がデータレポートとユーザーエクスペリエンスへの影響をレビューする必要があります。
- 自動チェック:可能であれば、ツールを使用して、実際のデータベースがドキュメントと一致していることを検証してください。これにより、手動での検証作業を削減できます。
- 定期監査:ドキュメントが本番環境から乖離していないことを確認するために、定期的な監査をスケジュールしてください。
コラボレーションは継続的なループです。プロジェクト開始時の一度きりの活動ではありません。要件が変化すれば、ドキュメントもそれに合わせて変化しなければなりません。
⚠️ ERD設計における一般的な落とし穴
標準が整備されていても、チームはしばしば一般的な罠にはまります。これらの落とし穴を早期に認識することで、多大な時間と労力を節約できます。
- 過剰設計:考えられるすべての将来のシナリオに対して設計すると、不必要な複雑さにつながります。現在の要件に焦点を当て、構造を過度に複雑にすることなく、成長の余地を残してください。
- パフォーマンスの無視:紙面上の完璧なスキーマでも、本番環境ではパフォーマンスが低下する可能性があります。設計フェーズでインデックス戦略とクエリパターンを考慮してください。
- 隠れた依存関係:すべての外部キー関係が明示的であることを確認してください。隠れたロジックは壊れやすいシステムを作り出します。
- ドキュメントの不足:図のみを頼りにし、補足テキストなしで運用するのはリスクがあります。複雑なロジックには文脈を説明する注釈が不可欠です。
📋 包括的な標準チェックリスト
公開前に、この表を使用して、ドキュメントが確立された標準に合致しているか確認してください。
| カテゴリ | 要件 | 優先度 |
|---|---|---|
| 命名規則 | すべてのテーブル名は複数形でスネークケースです | 高 |
| 命名規則 | 外部キーは次のパターンに従います_id |
高 |
| リレーションシップ | カーディナリティは明示的にマークされています | 高 |
| リレーションシップ | 多対多のリレーションシップにはジョインテーブルを使用します | 高 |
| メタデータ | 列のデータ型が指定されています | 中 |
| メタデータ | デフォルト値が文書化されています | 中 |
| バージョン管理 | 変更ログは最新です | 中 |
| バージョン管理 | バージョン番号は図面上に表示されています | 高 |
| アクセシビリティ | 図はすべてのチームメンバーにアクセス可能です | 高 |
| アクセシビリティ | 記号には凡例が含まれています | 中級 |
実装ガイドライン
これらの基準を採用するには規律が必要です。規則があるだけでは不十分で、日常業務に組み込まれる必要があります。
- オンボーディング:新入社員オリエンテーションに文書化基準を含めてください。各規則の背後にある理由を説明してください。
- テンプレート:必要なヘッダー、凡例、メタデータセクションを含むERD(ER図)のテンプレートを作成してください。
- コードレビュー:スキーマ文書化をコードレビュープロセスの一部として扱ってください。文書化が更新されていない状態でスキーマ変更をマージしないでください。
- フィードバックループ:チームメンバーに基準自体の改善案を提案するよう促してください。プロセスは進化していくべきです。
🚀 長期的な品質の維持
高品質なERD文書化を維持することは継続的な取り組みです。明確さへのコミットメントと、必要に応じてデータと文書化の両方をリファクタリングする意欲が必要です。
チームがこれらの基準に投資すると、その効果は明白です。要件の明確化に要する時間が減るため開発が加速します。制約が明確になるためエラーが減少します。視覚的な言語が共有されるためコミュニケーションが向上します。
まず現在の文書化を監査することから始めてください。混乱が最も頻繁に発生する領域を特定してください。このガイドで概説された基準をまずその特定の領域に適用してください。段階的に範囲を広げ、システム全体が新しい規範に従うまで続けてください。
データは資産です。明確な文書化を通じてその整合性を保護することは、技術チームが貢献できる最も価値ある取り組みの一つです。これらのガイドラインに従うことで、データモデルがアプリケーションエコシステム全体のための信頼できる基盤であり続けることを保証します。
明確さ、一貫性、そしてコミュニケーションに焦点を当ててください。これら3つの柱は、ソフトウェアのライフサイクルを通じてチームを効果的に支える文書化戦略を支えます。